4.4 메모리와 캐시 *
이 장의 앞선 두 절에서는 기본적이고 중요한 두 자료 구조인 배열과 연결 리스트를 살펴보았다. 이들은 각각 ‘연속 저장’과 ‘분산 저장’이라는 물리적 구조를 대표한다.
실제로 물리적 구조는 프로그램의 메모리 및 캐시 사용 효율을 크게 좌우하며, 나아가 알고리즘 프로그램의 전체 성능에 영향을 준다.
4.4.1 컴퓨터의 저장 장치
컴퓨터에는 하드 디스크(hard disk), 메모리(random-access memory, RAM), 캐시(cache memory)라는 세 종류의 저장 장치가 있다. 아래 표(4-2)는 컴퓨터 시스템에서 각 장치가 맡는 역할과 성능 특징을 보여 준다.
표 4-2 컴퓨터의 저장 장치
| 하드 디스크 | 메모리 | 캐시 | |
|---|---|---|---|
| 용도 | 운영체제, 프로그램, 파일 등의 데이터를 장기간 저장 | 실행 중인 프로그램과 처리 중인 데이터를 임시 저장 | 자주 접근하는 데이터와 명령어를 저장하여 CPU의 메모리 접근 횟수를 줄임 |
| 휘발성 | 전원이 꺼져도 데이터가 사라지지 않음 | 전원이 꺼지면 데이터가 사라짐 | 전원이 꺼지면 데이터가 사라짐 |
| 용량 | 큼, TB 단위 | 작음, GB 단위 | 매우 작음, MB 단위 |
| 속도 | 느림, 수백~수천 MB/s | 빠름, 수십 GB/s | 매우 빠름, 수십~수백 GB/s |
| 가격(중국 위안) | 저렴함, GB당 수십 펀~수 위안 | 비쌈, GB당 수십~수백 위안 | 매우 비쌈, CPU 가격에 포함 |
컴퓨터의 저장 시스템은 아래 그림(4-9)과 같은 피라미드 구조로 생각할 수 있다. 꼭대기에 가까울수록 속도는 빠르고, 용량은 작으며, 비용은 높다. 이러한 계층적 설계는 우연이 아니라 컴퓨터 과학자와 엔지니어들이 깊이 고민한 결과다.
- 메모리로 하드 디스크를 대체하기는 어렵다. 우선 메모리의 데이터는 전원이 꺼지면 사라지므로 장기 저장에 적합하지 않다. 또한 메모리 가격은 하드 디스크의 수십 배여서 소비자 시장에 보편적으로 적용하기 어렵다.
- 캐시에서 큰 용량과 빠른 속도를 동시에 얻기는 어렵다. L1, L2, L3 캐시의 용량이 커질수록 물리적 크기도 커지고 CPU 코어와의 거리도 멀어진다. 그 결과 데이터 전송 시간이 늘고 원소 접근 지연도 커진다. 현재 기술에서 다단계 캐시 구조는 용량, 속도, 비용 사이의 최적 절충점이다.
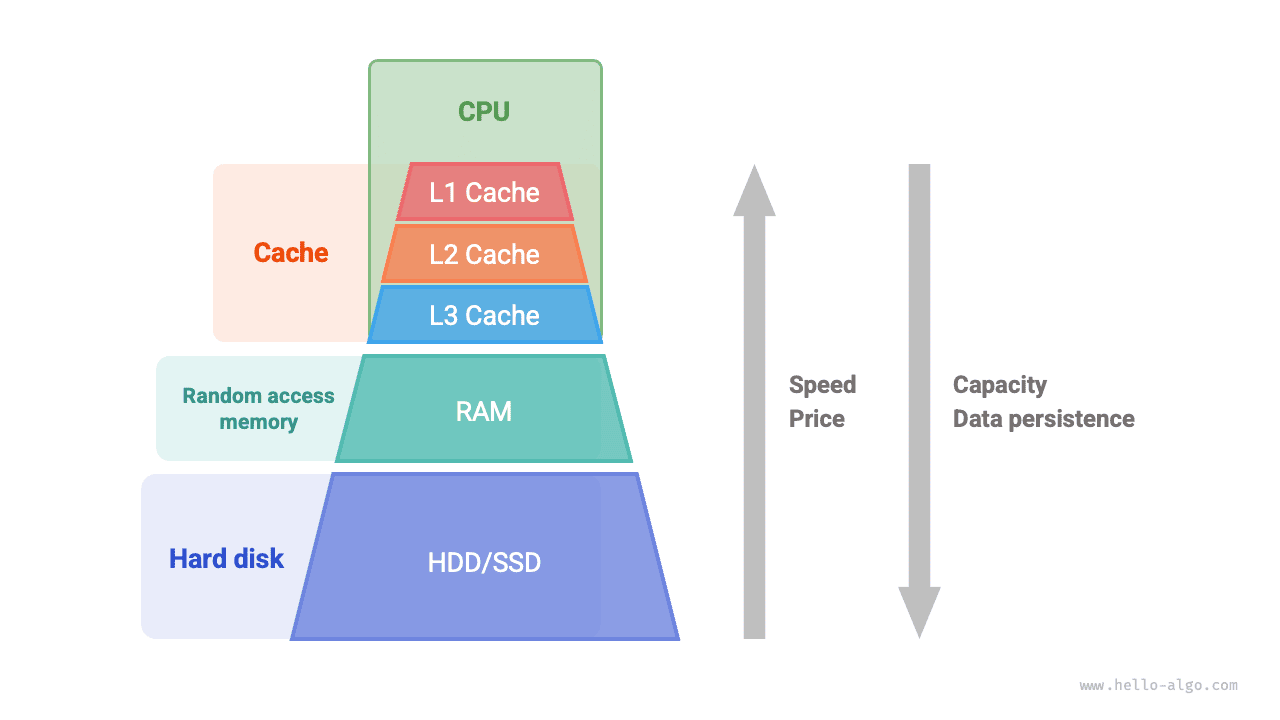
그림 4-9 컴퓨터 저장 시스템
참고
컴퓨터의 저장 계층 구조는 속도, 용량, 비용 사이의 정교한 균형을 보여 준다. 이러한 절충은 모든 산업 분야에 널리 존재하며, 서로 다른 장점과 제약 사이에서 최적의 균형을 찾아야 한다.
전체적으로 하드 디스크는 많은 데이터를 장기간 저장하고, 메모리는 실행 중인 프로그램이 처리하는 데이터를 임시 저장하며, 캐시는 자주 접근하는 데이터와 명령어를 저장하여 실행 효율을 높인다. 세 장치는 서로 협력하여 컴퓨터 시스템이 효율적으로 작동하게 한다.
아래 그림(4-10)과 같이 프로그램이 실행되면 하드 디스크의 데이터를 메모리로 읽어 와 CPU가 계산에 사용한다. 캐시는 CPU의 일부로 볼 수 있으며, 메모리에서 데이터를 지능적으로 불러와 CPU에 빠른 데이터 읽기를 제공한다. 이를 통해 실행 효율을 크게 높이고 더 느린 메모리에 대한 의존을 줄인다.
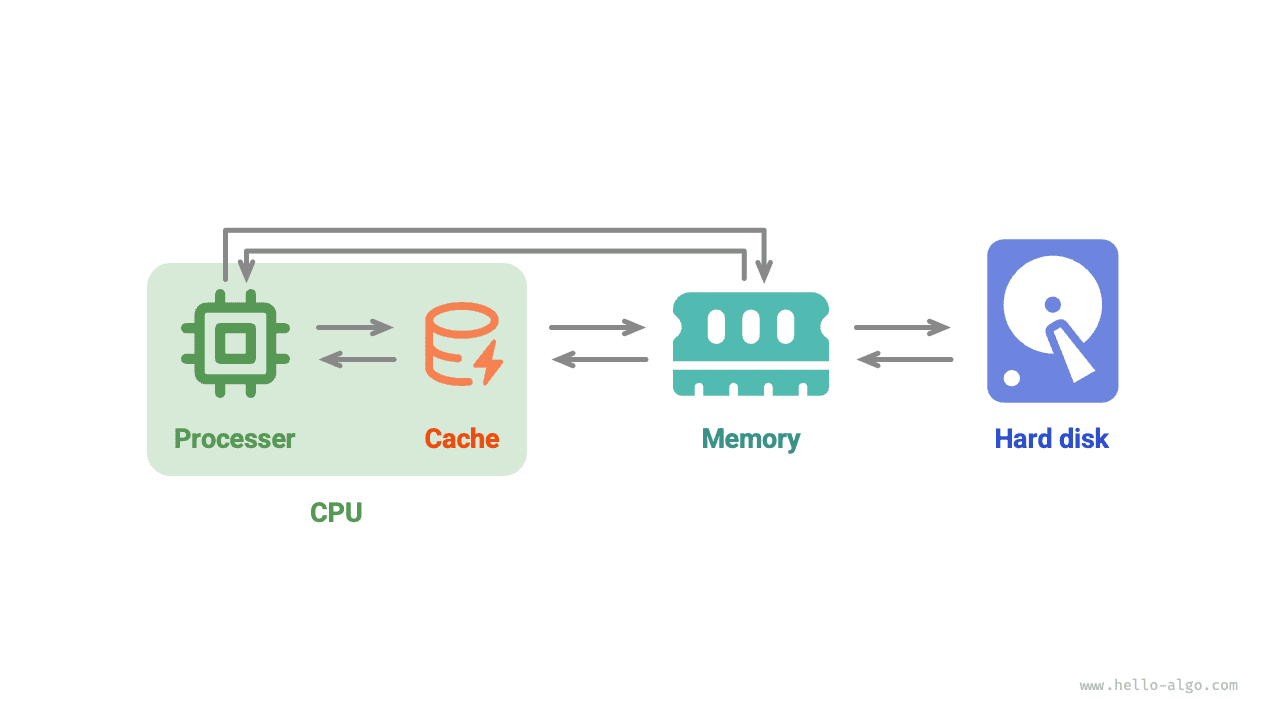
그림 4-10 하드 디스크, 메모리, 캐시 사이의 데이터 흐름
4.4.2 자료 구조의 메모리 효율
메모리 공간 활용 측면에서 배열과 연결 리스트에는 각각 장점과 한계가 있다.
한편으로 메모리는 한정되어 있으며 같은 메모리 영역을 여러 프로그램이 공유할 수 없으므로, 자료 구조가 공간을 최대한 효율적으로 사용하기를 바란다. 배열 원소는 빈틈없이 붙어 있어 연결 리스트 노드 사이의 참조(포인터)를 저장할 추가 공간이 필요 없으므로 공간 효율이 더 높다. 하지만 배열은 충분한 연속 메모리를 한꺼번에 할당해야 하므로 공간 낭비가 발생할 수 있으며, 용량 확장에도 시간과 공간이 추가로 든다. 반면 연결 리스트는 ‘노드’ 단위로 메모리를 동적으로 할당하고 회수하므로 더 유연하다.
다른 한편으로 프로그램이 실행되면서 메모리 할당과 해제가 반복되면 빈 메모리의 단편화가 점점 심해져 메모리 활용 효율이 낮아진다. 배열은 연속 저장 방식을 사용하므로 상대적으로 단편화를 덜 일으킨다. 반면 연결 리스트의 원소는 분산되어 있으므로 삽입과 삭제가 잦으면 단편화가 더 쉽게 발생한다.
4.4.3 자료 구조의 캐시 효율
캐시는 메모리보다 용량은 훨씬 작지만 속도는 훨씬 빨라 프로그램 실행 속도에 매우 중요한 역할을 한다. 용량이 제한되어 있어 자주 사용하는 데이터 일부만 저장할 수 있으므로, CPU가 접근하려는 데이터가 캐시에 없으면 캐시 미스(cache miss)가 발생한다. 이때 CPU는 더 느린 메모리에서 필요한 데이터를 불러와야 한다.
따라서 ‘캐시 미스’가 적을수록 CPU의 데이터 읽기 및 쓰기 효율이 높아지고, 프로그램 성능도 좋아진다. CPU가 캐시에서 데이터를 성공적으로 가져오는 비율을 캐시 적중률(cache hit rate)이라고 하며, 캐시 효율을 측정하는 지표로 자주 사용한다.
캐시는 효율을 최대한 높이기 위해 다음과 같은 데이터 로딩 방식을 사용한다.
- 캐시 라인: 캐시는 데이터를 한 바이트씩 저장하고 불러오는 대신 캐시 라인 단위로 처리한다. 캐시 라인 단위 전송은 바이트 단위 전송보다 효율적이다.
- 프리페치: 프로세서는 순차 접근이나 고정 간격 접근 같은 데이터 접근 패턴을 예측하고, 그 패턴에 따라 데이터를 미리 캐시에 불러와 적중률을 높인다.
- 공간 지역성: 어떤 데이터에 접근하면 가까운 시일 안에 주변 데이터에도 접근할 가능성이 있다. 따라서 캐시는 데이터를 불러올 때 주변 데이터도 함께 불러와 적중률을 높인다.
- 시간 지역성: 어떤 데이터에 접근하면 머지않아 다시 접근할 가능성이 높다. 캐시는 이 원리를 이용해 최근 접근한 데이터를 유지함으로써 적중률을 높인다.
실제로 배열과 연결 리스트의 캐시 활용 효율은 서로 다르며, 주로 다음과 같은 차이가 있다.
- 공간 사용량: 연결 리스트 원소는 배열 원소보다 더 많은 공간을 차지하므로 캐시에 담을 수 있는 유효 데이터의 양이 적다.
- 캐시 라인: 연결 리스트의 데이터는 메모리 곳곳에 흩어져 있지만 캐시는 ‘라인 단위’로 불러오므로, 불필요한 데이터를 가져오는 비율이 높다.
- 프리페치: 배열의 데이터 접근 패턴은 연결 리스트보다 ‘예측 가능성’이 높다. 즉, 시스템이 다음에 불러올 데이터를 더 쉽게 예상할 수 있다.
- 공간 지역성: 배열은 한곳에 모인 메모리 공간에 저장되므로, 불러온 데이터 주변의 데이터에도 곧 접근할 가능성이 더 높다.
대체로 배열은 캐시 적중률이 더 높아 연산 효율에서도 연결 리스트보다 유리한 경우가 많다. 이 때문에 알고리즘 문제를 풀 때는 배열 기반 자료 구조를 더 선호하는 경우가 많다.
다만 캐시 효율이 높다고 해서 모든 상황에서 배열이 연결 리스트보다 좋은 것은 아니다. 실제로 어떤 자료 구조를 쓸지는 구체적인 요구에 따라 결정해야 한다. 예를 들어 배열과 연결 리스트 모두 ‘스택’을 구현할 수 있지만(다음 장에서 자세히 설명한다), 적합한 상황은 다르다.
- 알고리즘 문제를 풀 때는 배열 기반 스택을 선호한다. 배열에 일정한 메모리 공간을 미리 할당하기만 하면, 높은 연산 효율과 임의 접근 기능을 얻을 수 있기 때문이다.
- 데이터가 매우 많고 변화가 잦으며 스택의 예상 크기를 가늠하기 어렵다면 연결 리스트 기반 스택이 더 적합하다. 연결 리스트는 많은 데이터를 메모리 여러 곳에 분산 저장할 수 있으며, 배열 용량 확장에 따른 추가 비용도 피할 수 있다.