11.8 버킷 정렬
앞에서 살펴본 정렬 알고리즘은 모두 원소의 크기를 비교하여 정렬하는 '비교 기반 정렬 알고리즘'이다. 이 알고리즘들의 최악 시간 복잡도 하한은 \(\Omega(n \log n)\)이다. 이제 시간 복잡도가 선형에 이를 수 있는 몇 가지 '비교를 사용하지 않는 정렬 알고리즘'을 살펴보자.
버킷 정렬(bucket sort)은 분할 정복 전략의 대표적인 응용이다. 크기순으로 배열된 여러 버킷을 만들고 각 버킷에 데이터 범위를 대응시킨 뒤, 데이터를 각 버킷에 고르게 분배한다. 이어서 버킷별로 내부 정렬을 수행하고, 마지막으로 버킷 순서대로 모든 데이터를 합친다.
11.8.1 알고리즘 과정
길이가 \(n\)이고 원소가 범위 \([0, 1)\)의 부동 소수점 수인 배열을 생각해 보자. 버킷 정렬의 과정은 아래 그림(11-13)과 같다.
- 버킷 \(k\) 개를 초기화하고 원소 \(n\) 개를 이 \(k\) 개의 버킷에 분배한다.
- 각 버킷을 따로 정렬한다(여기서는 프로그래밍 언어의 내장 정렬 함수를 사용한다).
- 작은 버킷부터 큰 버킷 순서로 결과를 합친다.
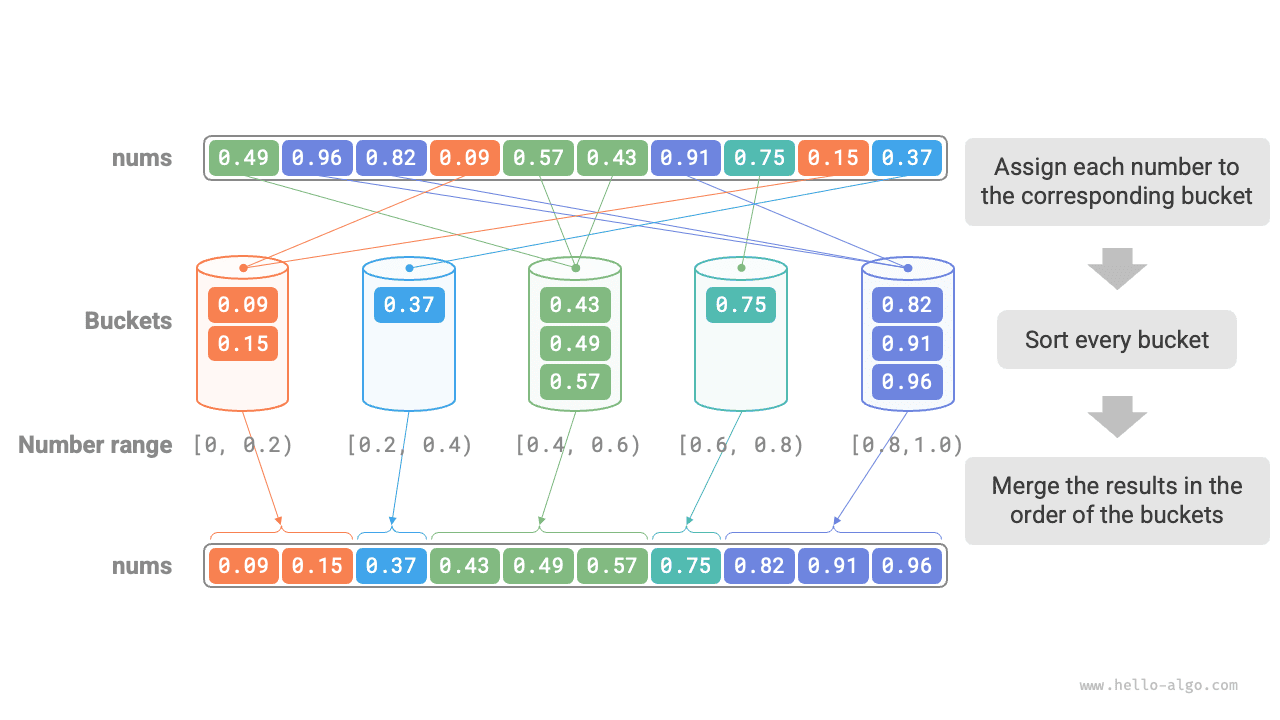
그림 11-13 버킷 정렬 알고리즘 과정
코드는 다음과 같다.
def bucket_sort(nums: list[float]):
    """버킷 정렬"""
    # 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
    k = len(nums) // 2
    buckets = [[] for _ in range(k)]
    # 1. 배열 원소를 각 버킷에 배정한다
    for num in nums:
        # 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
        i = int(num * k)
        # num을 버킷 i에 추가한다
        buckets[i].append(num)
    # 2. 각 버킷을 정렬한다
    for bucket in buckets:
        # 내장 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
        bucket.sort()
    # 3. 버킷을 순회하여 결과를 합친다
    i = 0
    for bucket in buckets:
        for num in bucket:
            nums[i] = num
            i += 1
/* 버킷 정렬 */
void bucketSort(vector<float> &nums) {
    // 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
    int k = nums.size() / 2;
    vector<vector<float>> buckets(k);
    // 1. 배열 원소를 각 버킷에 배정한다
    for (float num : nums) {
        // 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
        int i = num * k;
        // num을 버킷 bucket_idx에 추가한다
        buckets[i].push_back(num);
    }
    // 2. 각 버킷을 정렬한다
    for (vector<float> &bucket : buckets) {
        // 내장 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
        sort(bucket.begin(), bucket.end());
    }
    // 3. 버킷을 순회하여 결과를 합친다
    int i = 0;
    for (vector<float> &bucket : buckets) {
        for (float num : bucket) {
            nums[i++] = num;
        }
    }
}
/* 버킷 정렬 */
void bucketSort(float[] nums) {
    // 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
    int k = nums.length / 2;
    List<List<Float>> buckets = new ArrayList<>();
    for (int i = 0; i < k; i++) {
        buckets.add(new ArrayList<>());
    }
    // 1. 배열 원소를 각 버킷에 배정한다
    for (float num : nums) {
        // 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
        int i = (int) (num * k);
        // num을 버킷 i에 추가한다
        buckets.get(i).add(num);
    }
    // 2. 각 버킷을 정렬한다
    for (List<Float> bucket : buckets) {
        // 내장 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
        Collections.sort(bucket);
    }
    // 3. 버킷을 순회하여 결과를 합친다
    int i = 0;
    for (List<Float> bucket : buckets) {
        for (float num : bucket) {
            nums[i++] = num;
        }
    }
}
/* 버킷 정렬 */
void BucketSort(float[] nums) {
    // 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
    int k = nums.Length / 2;
    List<List<float>> buckets = [];
    for (int i = 0; i < k; i++) {
        buckets.Add([]);
    }
    // 1. 배열 원소를 각 버킷에 배정한다
    foreach (float num in nums) {
        // 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
        int i = (int)(num * k);
        // num을 버킷 i에 추가한다
        buckets[i].Add(num);
    }
    // 2. 각 버킷을 정렬한다
    foreach (List<float> bucket in buckets) {
        // 내장 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
        bucket.Sort();
    }
    // 3. 버킷을 순회하여 결과를 합친다
    int j = 0;
    foreach (List<float> bucket in buckets) {
        foreach (float num in bucket) {
            nums[j++] = num;
        }
    }
}
/* 버킷 정렬 */
func bucketSort(nums []float64) {
    // 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
    k := len(nums) / 2
    buckets := make([][]float64, k)
    for i := 0; i < k; i++ {
        buckets[i] = make([]float64, 0)
    }
    // 1. 배열 원소를 각 버킷에 배정한다
    for _, num := range nums {
        // 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
        i := int(num * float64(k))
        // num을 버킷 i에 추가한다
        buckets[i] = append(buckets[i], num)
    }
    // 2. 각 버킷을 정렬한다
    for i := 0; i < k; i++ {
        // 내장 슬라이스 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
        sort.Float64s(buckets[i])
    }
    // 3. 버킷을 순회하여 결과를 합친다
    i := 0
    for _, bucket := range buckets {
        for _, num := range bucket {
            nums[i] = num
            i++
        }
    }
}
/* 버킷 정렬 */
func bucketSort(nums: inout [Double]) {
    // 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
    let k = nums.count / 2
    var buckets = (0 ..< k).map { _ in [Double]() }
    // 1. 배열 원소를 각 버킷에 배정한다
    for num in nums {
        // 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
        let i = Int(num * Double(k))
        // num을 버킷 i에 추가한다
        buckets[i].append(num)
    }
    // 2. 각 버킷을 정렬한다
    for i in buckets.indices {
        // 내장 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
        buckets[i].sort()
    }
    // 3. 버킷을 순회하여 결과를 합친다
    var i = nums.startIndex
    for bucket in buckets {
        for num in bucket {
            nums[i] = num
            i += 1
        }
    }
}
/* 버킷 정렬 */
function bucketSort(nums) {
    // 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
    const k = nums.length / 2;
    const buckets = [];
    for (let i = 0; i < k; i++) {
        buckets.push([]);
    }
    // 1. 배열 원소를 각 버킷에 배정한다
    for (const num of nums) {
        // 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
        const i = Math.floor(num * k);
        // num을 버킷 i에 추가한다
        buckets[i].push(num);
    }
    // 2. 각 버킷을 정렬한다
    for (const bucket of buckets) {
        // 내장 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
        bucket.sort((a, b) => a - b);
    }
    // 3. 버킷을 순회하여 결과를 합친다
    let i = 0;
    for (const bucket of buckets) {
        for (const num of bucket) {
            nums[i++] = num;
        }
    }
}
/* 버킷 정렬 */
function bucketSort(nums: number[]): void {
    // 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
    const k = nums.length / 2;
    const buckets: number[][] = [];
    for (let i = 0; i < k; i++) {
        buckets.push([]);
    }
    // 1. 배열 원소를 각 버킷에 배정한다
    for (const num of nums) {
        // 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
        const i = Math.floor(num * k);
        // num을 버킷 i에 추가한다
        buckets[i].push(num);
    }
    // 2. 각 버킷을 정렬한다
    for (const bucket of buckets) {
        // 내장 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
        bucket.sort((a, b) => a - b);
    }
    // 3. 버킷을 순회하여 결과를 합친다
    let i = 0;
    for (const bucket of buckets) {
        for (const num of bucket) {
            nums[i++] = num;
        }
    }
}
/* 버킷 정렬 */
void bucketSort(List<double> nums) {
  // 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
  int k = nums.length ~/ 2;
  List<List<double>> buckets = List.generate(k, (index) => []);

  // 1. 배열 원소를 각 버킷에 배정한다
  for (double _num in nums) {
    // 입력 데이터의 범위는 [0, 1)이며, _num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
    int i = (_num * k).toInt();
    // _num을 버킷 bucket_idx에 추가한다
    buckets[i].add(_num);
  }
  // 2. 각 버킷을 정렬한다
  for (List<double> bucket in buckets) {
    bucket.sort();
  }
  // 3. 버킷을 순회하여 결과를 합친다
  int i = 0;
  for (List<double> bucket in buckets) {
    for (double _num in bucket) {
      nums[i++] = _num;
    }
  }
}
/* 버킷 정렬 */
fn bucket_sort(nums: &mut [f64]) {
    // 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
    let k = nums.len() / 2;
    let mut buckets = vec![vec![]; k];
    // 1. 배열 원소를 각 버킷에 배정한다
    for &num in nums.iter() {
        // 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
        let i = (num * k as f64) as usize;
        // num을 버킷 i에 추가한다
        buckets[i].push(num);
    }
    // 2. 각 버킷을 정렬한다
    for bucket in &mut buckets {
        // 내장 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
        bucket.sort_by(|a, b| a.partial_cmp(b).unwrap());
    }
    // 3. 버킷을 순회하여 결과를 합친다
    let mut i = 0;
    for bucket in buckets.iter() {
        for &num in bucket.iter() {
            nums[i] = num;
            i += 1;
        }
    }
}
/* 버킷 정렬 */
void bucketSort(float nums[], int n) {
    int k = n / 2;                                 // k = n/2개의 버킷을 초기화한다
    int *sizes = malloc(k * sizeof(int));          // 각 버킷의 크기를 기록한다
    float **buckets = malloc(k * sizeof(float *)); // 동적 배열의 배열(버킷)
    // 각 버킷에 충분한 공간을 미리 할당한다
    for (int i = 0; i < k; ++i) {
        buckets[i] = (float *)malloc(n * sizeof(float));
        sizes[i] = 0;
    }
    // 1. 배열 원소를 각 버킷에 배정한다
    for (int i = 0; i < n; ++i) {
        int idx = (int)(nums[i] * k);
        buckets[idx][sizes[idx]++] = nums[i];
    }
    // 2. 각 버킷을 정렬한다
    for (int i = 0; i < k; ++i) {
        qsort(buckets[i], sizes[i], sizeof(float), compare);
    }
    // 3. 정렬한 버킷을 병합한다
    int idx = 0;
    for (int i = 0; i < k; ++i) {
        for (int j = 0; j < sizes[i]; ++j) {
            nums[idx++] = buckets[i][j];
        }
        // 메모리 해제
        free(buckets[i]);
    }
}
/* 버킷 정렬 */
fun bucketSort(nums: FloatArray) {
    // 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
    val k = nums.size / 2
    val buckets = mutableListOf<MutableList<Float>>()
    for (i in 0..<k) {
        buckets.add(mutableListOf())
    }
    // 1. 배열 원소를 각 버킷에 배정한다
    for (num in nums) {
        // 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
        val i = (num * k).toInt()
        // num을 버킷 i에 추가한다
        buckets[i].add(num)
    }
    // 2. 각 버킷을 정렬한다
    for (bucket in buckets) {
        // 내장 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
        bucket.sort()
    }
    // 3. 버킷을 순회하여 결과를 합친다
    var i = 0
    for (bucket in buckets) {
        for (num in bucket) {
            nums[i++] = num
        }
    }
}
### 버킷 정렬 ###
def bucket_sort(nums)
  # 버킷 k = n/2개를 초기화하며, 각 버킷에 원소 2개가 배정될 것으로 예상한다
  k = nums.length / 2
  buckets = Array.new(k) { [] }

  # 1. 배열 원소를 각 버킷에 배정한다
  nums.each do |num|
    # 입력 데이터의 범위는 [0, 1)이며, num * k를 사용하여 인덱스 범위 [0, k-1]에 대응시킨다
    i = (num * k).to_i
    # num을 버킷 i에 추가한다
    buckets[i] << num
  end

  # 2. 각 버킷을 정렬한다
  buckets.each do |bucket|
    # 내장 정렬 함수를 사용하며, 다른 정렬 알고리즘으로 대체할 수도 있다
    bucket.sort!
  end

  # 3. 버킷을 순회하여 결과를 합친다
  i = 0
  buckets.each do |bucket|
    bucket.each do |num|
      nums[i] = num
      i += 1
    end
  end
end
코드 시각화
11.8.2 알고리즘 특성
버킷 정렬은 매우 큰 데이터를 처리하는 데 적합하다. 예를 들어 입력에 원소가 100만 개 있고 공간 제약 때문에 시스템 메모리에 모든 데이터를 한 번에 올릴 수 없다고 하자. 이때 데이터를 1000개 버킷으로 나누어 각각 정렬한 다음 결과를 합칠 수 있다.
- 시간 복잡도 \(O(n + k)\): 원소가 각 버킷에 고르게 분포한다면 버킷당 원소 수는 \(\frac{n}{k}\)이다. 버킷 하나를 정렬하는 데 \(O(\frac{n}{k} \log\frac{n}{k})\) 시간이 걸린다고 하면 모든 버킷의 정렬에는 \(O(n \log\frac{n}{k})\) 시간이 걸린다. 버킷 수 \(k\)가 충분히 크면 시간 복잡도는 \(O(n)\)에 가까워진다. 결과를 합칠 때는 모든 버킷과 원소를 순회하므로 \(O(n + k)\) 시간이 든다. 최악의 경우 모든 데이터가 하나의 버킷에 들어가며, 그 버킷을 정렬하는 데 \(O(n^2)\) 시간이 걸린다.
- 공간 복잡도 \(O(n + k)\), 제자리 정렬이 아님: 버킷 \(k\) 개와 총 \(n\) 개의 원소를 위한 추가 공간이 필요하다.
- 버킷 정렬의 안정성은 버킷 내부를 정렬하는 알고리즘의 안정성에 달려 있다.
11.8.3 고르게 분배하는 방법
버킷 정렬의 시간 복잡도는 이론적으로 \(O(n)\)에 이를 수 있다. 핵심은 원소를 각 버킷에 고르게 분배하는 것인데, 실제 데이터는 균일하게 분포하지 않는 경우가 많다. 예를 들어 타오바오의 모든 상품을 가격 범위에 따라 10개 버킷에 고르게 나누고 싶다고 하자. 상품 가격은 불균일하여 100위안 미만의 상품은 매우 많고 1000위안 초과 상품은 매우 적다. 가격 구간을 같은 폭으로 10등분하면 버킷별 상품 수에 큰 차이가 생긴다.
고르게 분배하려면 먼저 대략적인 경계를 정해 데이터를 버킷 3개로 나눌 수 있다. 분배한 뒤 상품이 많은 버킷을 다시 3개로 나누고, 모든 버킷의 원소 수가 비슷해질 때까지 반복한다.
아래 그림(11-14)과 같이 이 방법은 본질적으로 재귀 트리를 만드는 과정이며, 리프 노드의 값을 가능한 한 고르게 만드는 것이 목표다. 반드시 매번 버킷 3개로 나눌 필요는 없으며, 데이터 특성에 맞추어 분할 방식을 유연하게 선택할 수 있다.
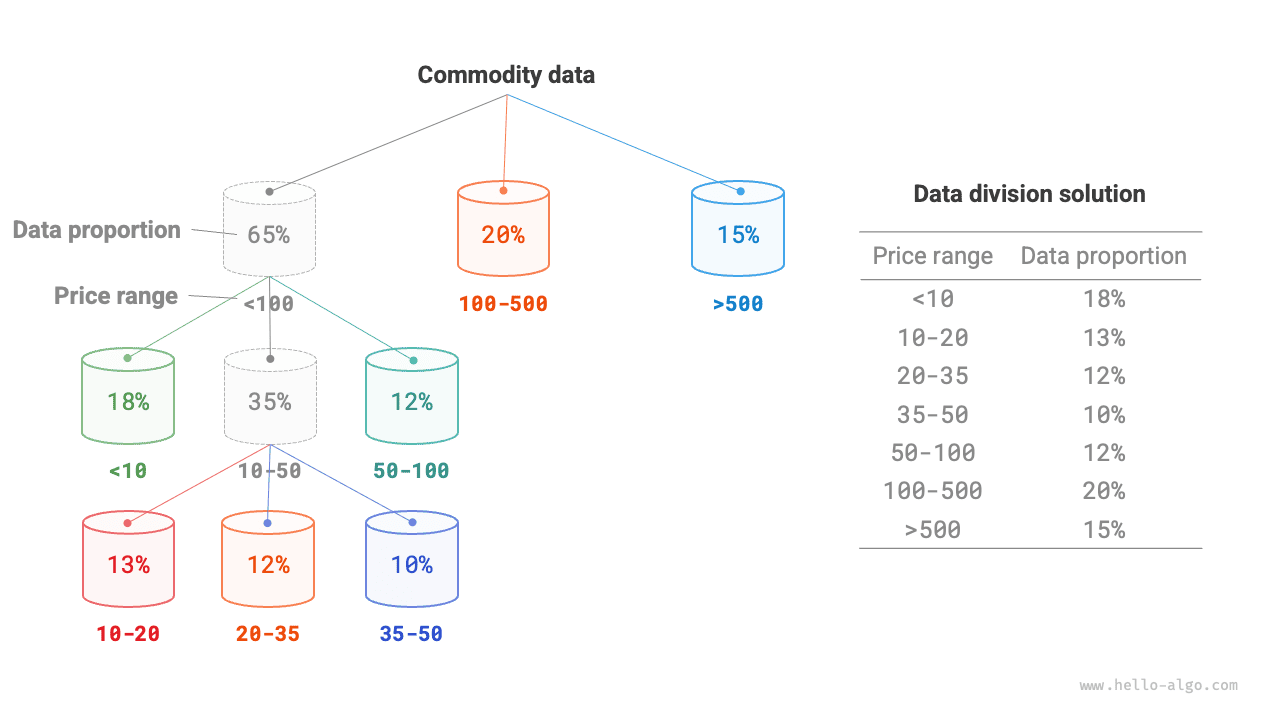
그림 11-14 버킷을 재귀적으로 분할
상품 가격의 확률 분포를 미리 알고 있다면 그 분포에 따라 각 버킷의 가격 경계를 설정할 수 있다. 데이터 분포를 반드시 따로 집계할 필요는 없으며, 데이터 특성에 따라 적절한 확률 모형으로 근사할 수도 있다.
아래 그림(11-15)에서는 상품 가격이 정규 분포를 따른다고 가정한다. 이를 바탕으로 가격 구간을 적절히 정하면 상품을 각 버킷에 고르게 분배할 수 있다.
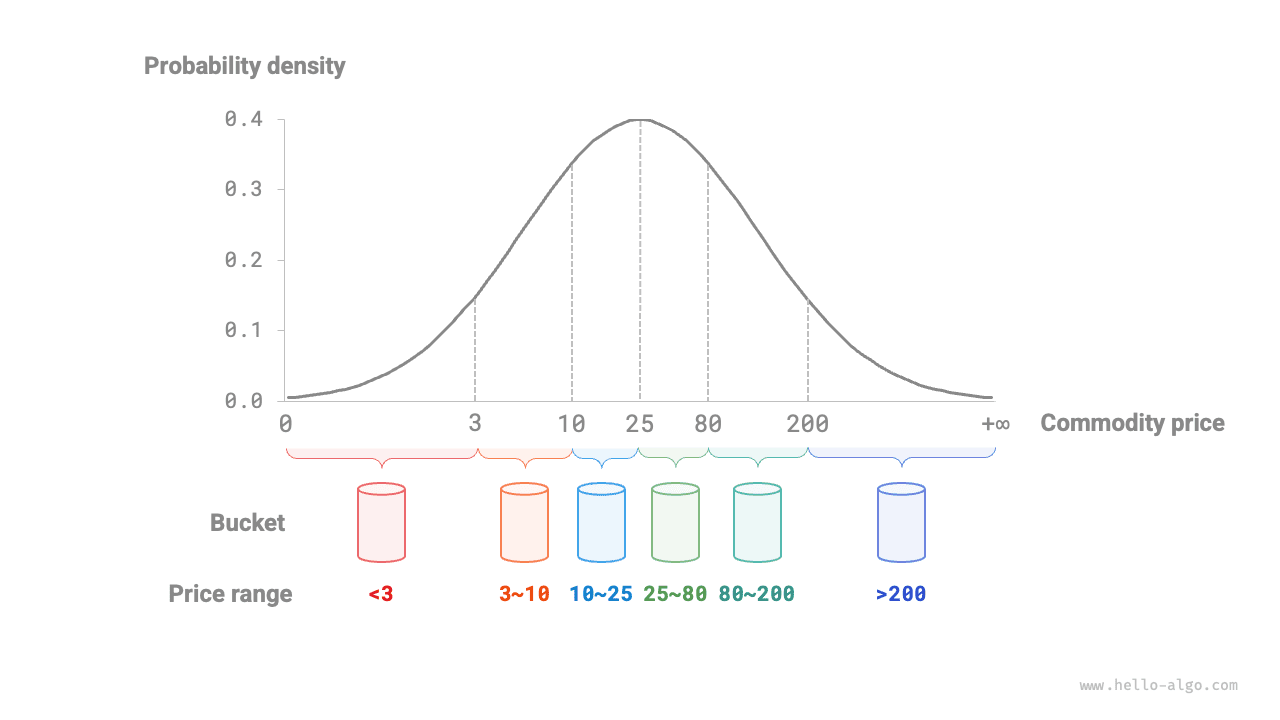
그림 11-15 확률 분포에 따른 버킷 분할