3.3 수의 인코딩 *
참고
이 책에서 제목에 * 기호가 있는 절은 선택 학습 내용이다. 시간이 부족하거나 이해하기 어렵다면 먼저 건너뛰고, 필수 내용을 학습한 뒤 따로 도전해도 좋다.
3.3.1 부호와 크기, 1의 보수, 2의 보수
앞 절의 표에서 모든 정수형은 표현할 수 있는 음수가 양수보다 하나 더 많았다. 예를 들어 byte의 값 범위는 \([-128, 127]\)이다. 직관과 어긋나는 이 현상의 이유를 이해하려면 부호와 크기, 1의 보수, 2의 보수에 대해 알아야 한다.
먼저 수는 컴퓨터에 ‘2의 보수’ 형태로 저장된다는 점을 알아 두자. 그 이유를 분석하기 전에 세 가지 표현을 정의하겠다.
- 부호와 크기: 이진수 표현의 최상위 비트를 부호 비트로 사용한다. \(0\)은 양수, \(1\)은 음수를 나타내며 나머지 비트는 수의 크기를 나타낸다.
- 1의 보수: 양수의 1의 보수는 부호와 크기 표현과 같다. 음수의 1의 보수는 부호와 크기 표현에서 부호 비트를 제외한 모든 비트를 반전한 것이다.
- 2의 보수: 양수의 2의 보수는 부호와 크기 표현과 같다. 음수의 2의 보수는 1의 보수에 \(1\)을 더한 것이다.
아래 그림(3-4)은 부호와 크기, 1의 보수, 2의 보수를 서로 변환하는 방법을 보여 준다.
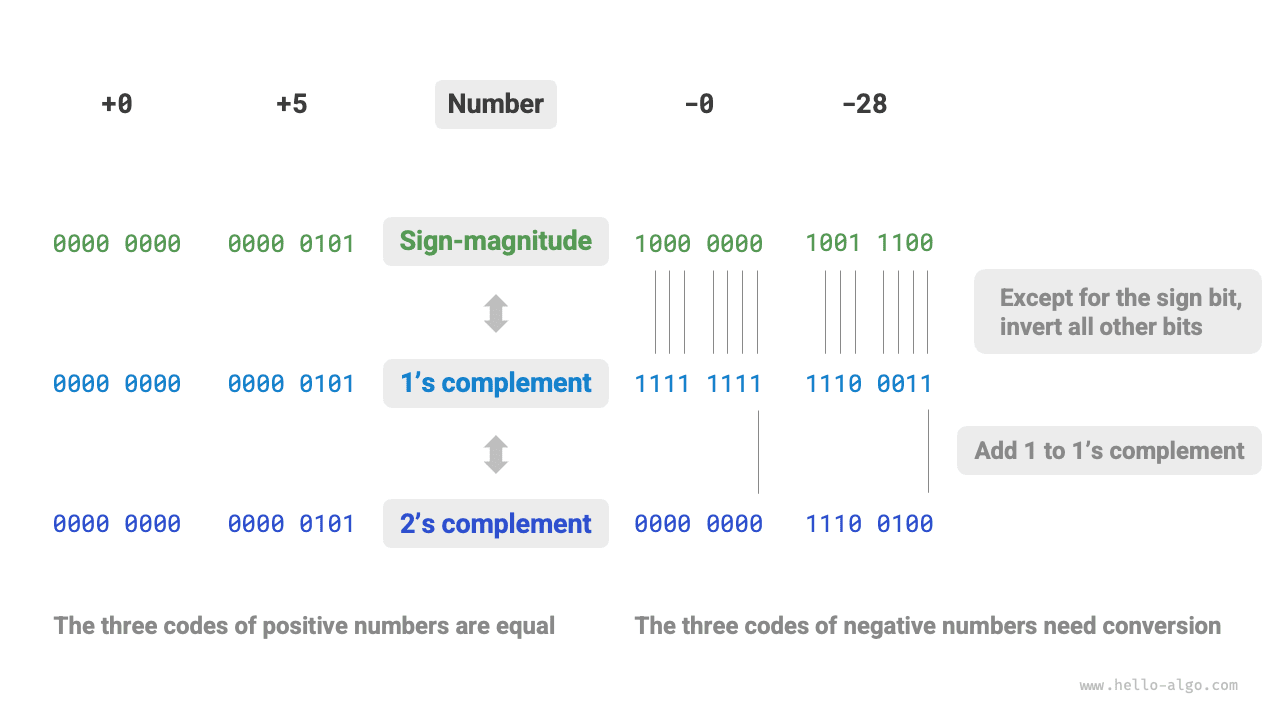
그림 3-4 부호와 크기, 1의 보수, 2의 보수의 상호 변환
부호와 크기(sign-magnitude) 표현은 가장 직관적이지만 한계가 있다. 우선 음수의 부호와 크기 표현은 연산에 그대로 사용할 수 없다. 예를 들어 이 표현으로 \(1 + (-2)\)를 계산하면 결과가 \(-3\)이 되어 명백히 틀린다.
이 문제를 해결하기 위해 1의 보수(1's complement)가 도입되었다. 부호와 크기 표현을 먼저 1의 보수로 바꾸고 \(1 + (-2)\)를 계산한 뒤, 결과를 다시 부호와 크기 표현으로 바꾸면 올바른 결과인 \(-1\)을 얻는다.
또한 부호와 크기 표현에서는 0을 \(+0\)과 \(-0\)의 두 가지 방식으로 나타낸다. 즉, 0에 서로 다른 두 이진 인코딩이 대응하므로 모호함이 생길 수 있다. 예를 들어 조건을 판단할 때 양의 0과 음의 0을 구분하지 않으면 결과가 틀릴 수 있다. 이러한 모호함을 처리하려면 추가 판단 연산이 필요하므로 컴퓨터의 연산 효율이 낮아질 수 있다.
1의 보수에도 부호와 크기 표현처럼 양의 0과 음의 0의 모호함이 있다. 그래서 2의 보수(2's complement)가 도입되었다. 먼저 음의 0을 부호와 크기, 1의 보수, 2의 보수로 변환하는 과정을 살펴보자.
음의 0의 1의 보수에 \(1\)을 더하면 자리 올림이 발생한다. 그러나 byte는 길이가 8비트뿐이므로 9번째 비트로 넘친 \(1\)은 버려진다. 즉, 음의 0의 2의 보수는 \(0000 \; 0000\)으로, 양의 0의 2의 보수와 같다. 따라서 2의 보수 표현에는 0이 하나만 존재하며, 양의 0과 음의 0의 모호함이 해결된다.
마지막 의문이 남는다. byte의 값 범위는 \([-128, 127]\)인데, 하나 더 있는 음수 \(-128\)은 어떻게 얻을까? 구간 \([-127, +127]\)의 모든 정수에는 대응하는 부호와 크기, 1의 보수, 2의 보수 표현이 있으며, 부호와 크기 표현과 2의 보수는 서로 변환할 수 있다.
그러나 2의 보수 \(1000 \; 0000\)은 예외로, 대응하는 부호와 크기 표현이 없다. 변환 방법을 적용하면 부호와 크기 표현으로 \(0000 \; 0000\)을 얻는다. 하지만 이 표현은 수 \(0\)을 나타내며 2의 보수도 자기 자신이어야 하므로 모순이다. 컴퓨터에서는 이 특수한 2의 보수 \(1000 \; 0000\)이 \(-128\)을 나타내도록 정한다. 실제로 \((-1) + (-127)\)을 2의 보수로 계산한 결과는 \(-128\)이다.
위의 계산이 모두 덧셈이라는 사실을 발견했을 것이다. 여기에는 중요한 사실이 담겨 있다. 컴퓨터 내부의 하드웨어 회로는 주로 덧셈 연산을 기반으로 설계된다. 덧셈은 곱셈, 나눗셈, 뺄셈 같은 다른 연산보다 하드웨어로 구현하기 쉽고, 병렬 처리도 쉬우며, 연산 속도도 빠르기 때문이다.
그렇다고 컴퓨터가 덧셈만 할 수 있다는 뜻은 아니다. 덧셈과 몇 가지 기본 논리 연산을 결합하면 다양한 수학 연산을 구현할 수 있다. 예를 들어 뺄셈 \(a - b\)는 덧셈 \(a + (-b)\)로 바꿀 수 있고, 곱셈과 나눗셈도 여러 번의 덧셈이나 뺄셈으로 바꿀 수 있다.
이제 컴퓨터가 2의 보수를 사용하는 이유를 정리할 수 있다. 2의 보수 표현을 쓰면 같은 회로와 연산으로 양수와 음수의 덧셈을 처리할 수 있다. 뺄셈을 위한 별도 하드웨어 회로를 설계할 필요가 없으며, 양의 0과 음의 0의 모호함도 따로 처리하지 않아도 된다. 이는 하드웨어 설계를 크게 단순화하고 연산 효율을 높인다.
2의 보수는 매우 정교하게 설계된 방식이지만, 분량상 여기까지만 소개한다. 관심 있는 독자는 더 깊이 알아보기를 권한다.
3.3.2 부동 소수점 인코딩
자세히 살펴보면 이런 의문이 생긴다. int와 float는 모두 4바이트로 길이가 같은데, 왜 float의 값 범위가 int보다 훨씬 넓을까? float는 소수도 표현해야 하므로 오히려 값 범위가 줄어들 것 같아 직관과 어긋난다.
실제로 이는 부동 소수점형 float가 다른 표현 방식을 사용하기 때문이다. 길이가 32비트인 이진수를 다음과 같이 쓰자.
IEEE 754 표준에 따르면 32비트 float는 다음 세 부분으로 이루어진다.
- 부호 비트 \(\mathrm{S}\): 1비트를 차지하며 \(b_{31}\)에 해당한다.
- 지수 비트 \(\mathrm{E}\): 8비트를 차지하며 \(b_{30} b_{29} \ldots b_{23}\)에 해당한다.
- 가수의 소수부 비트 \(\mathrm{N}\): 23비트를 차지하며 \(b_{22} b_{21} \ldots b_0\)에 해당한다.
이진수 float가 나타내는 값을 계산하는 방법은 다음과 같다.
이를 십진수로 바꾸면 다음 식을 얻는다.
각 항의 값 범위는 다음과 같다.
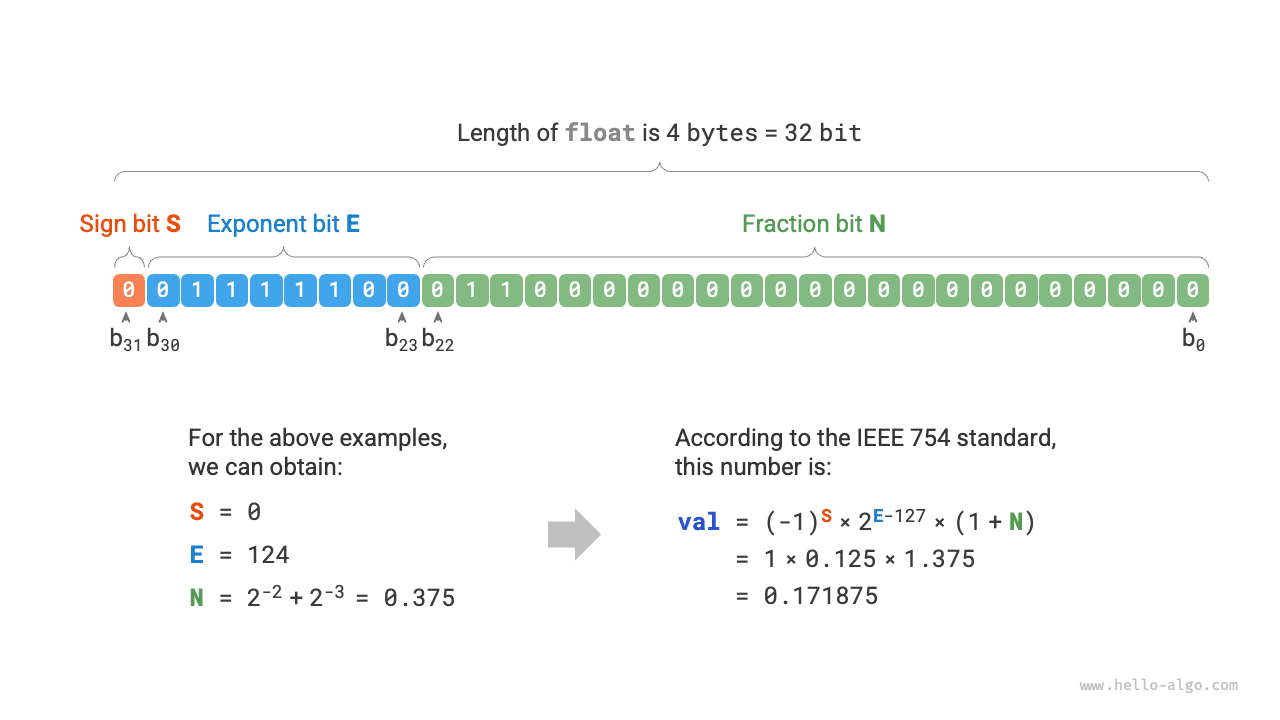
그림 3-5 IEEE 754 표준에 따른 float 계산 예
위 그림(3-5)에서 예로 든 데이터가 \(\mathrm{S} = 0\), \(\mathrm{E} = 124\), \(\mathrm{N} = 2^{-2} + 2^{-3} = 0.375\)이면 다음과 같다.
이제 처음의 질문에 답할 수 있다. float의 표현 방식에는 지수 비트가 있으므로 값 범위가 int보다 훨씬 넓다. 위 계산에 따르면 float로 표현할 수 있는 가장 큰 양수는 \(2^{254 - 127} \times (2 - 2^{-23}) \approx 3.4 \times 10^{38}\)이며, 부호 비트를 바꾸면 가장 작은 음수를 얻는다.
부동 소수점형 float는 값 범위를 넓히는 대신 정밀도를 희생한다. 정수형 int는 32비트 전체로 수를 표현하므로 수들이 균일하게 분포한다. 반면 부동 소수점형 float는 지수 비트 때문에 값이 커질수록 인접한 두 수 사이의 간격도 커지는 경향이 있다.
아래 표(3-2)와 같이 지수 비트 \(\mathrm{E} = 0\)과 \(\mathrm{E} = 255\)는 특별한 의미를 가지며, 0, 무한대, \(\mathrm{NaN}\) 등을 표현하는 데 사용된다.
표 3-2 지수 비트의 의미
| 지수 비트 E | 소수부 \(\mathrm{N} = 0\) | 소수부 \(\mathrm{N} \ne 0\) | 계산식 |
|---|---|---|---|
| \(0\) | \(\pm 0\) | 비정규화 수 | \((-1)^{\mathrm{S}} \times 2^{-126} \times (0.\mathrm{N})\) |
| \(1, 2, \dots, 254\) | 정규화 수 | 정규화 수 | \((-1)^{\mathrm{S}} \times 2^{(\mathrm{E} -127)} \times (1.\mathrm{N})\) |
| \(255\) | \(\pm \infty\) | \(\mathrm{NaN}\) |
비정규화 수는 부동 소수점의 정밀도를 크게 높인다는 점도 알아 두자. 가장 작은 양의 정규화 수는 \(2^{-126}\)이고, 가장 작은 양의 비정규화 수는 \(2^{-126} \times 2^{-23}\)이다.
배정밀도 double도 float와 비슷한 표현 방식을 사용하므로 여기서는 자세한 설명을 생략한다.