11.11 요약
1. 핵심 정리
- 버블 정렬은 인접한 원소를 교환하여 정렬한다. 플래그를 추가해 조기에 반환하도록 하면 최선 시간 복잡도를 \(O(n)\)으로 최적화할 수 있다.
- 삽입 정렬은 매번 미정렬 구간의 원소를 정렬된 구간의 올바른 위치에 삽입한다. 시간 복잡도는 \(O(n^2)\)이지만 기본 연산 수가 비교적 적어, 데이터가 적은 정렬 작업에서 매우 많이 사용된다.
- 퀵 정렬은 센티널 분할 연산으로 정렬한다. 분할할 때마다 최악의 피벗을 고르면 시간 복잡도가 \(O(n^2)\)으로 저하될 수 있다. 중앙값이나 무작위 원소를 피벗으로 사용하면 이런 확률을 줄일 수 있다. 더 짧은 부분 구간에 먼저 재귀하면 재귀 깊이를 효과적으로 줄여 공간 복잡도를 \(O(\log n)\)으로 최적화할 수 있다.
- 병합 정렬은 분할과 병합의 두 단계로 이루어지며 분할 정복 전략을 전형적으로 보여 준다. 배열을 정렬할 때는 보조 배열이 필요하여 공간 복잡도가 \(O(n)\)이지만, 연결 리스트 정렬은 \(O(1)\)까지 최적화할 수 있다.
- 버킷 정렬은 데이터를 버킷에 분배하고, 각 버킷 안에서 정렬하고, 결과를 합치는 세 단계로 이루어진다. 역시 분할 정복 전략을 보여 주며 매우 큰 데이터에 적합하다. 핵심은 데이터를 고르게 분배하는 것이다.
- 계수 정렬은 버킷 정렬의 특수한 경우로, 데이터의 등장 횟수를 세어 정렬한다. 데이터 수는 많지만 값의 범위가 제한된 경우에 적합하며, 데이터를 양의 정수로 변환할 수 있어야 한다.
- 기수 정렬은 자릿수별로 정렬하여 전체 데이터를 정렬하며, 데이터를 고정된 자릿수의 수로 표현할 수 있어야 한다.
- 우리는 효율, 안정성, 제자리 동작, 적응성 등의 장점을 갖춘 정렬 알고리즘을 원한다. 하지만 다른 자료 구조와 알고리즘처럼 이 모든 조건을 동시에 만족하는 정렬 알고리즘은 없다. 실제 응용에서는 데이터의 특성에 따라 적합한 알고리즘을 선택해야 한다.
- 아래 그림(11-19)은 주요 정렬 알고리즘의 효율, 안정성, 제자리 여부, 적응성 등을 비교한다.
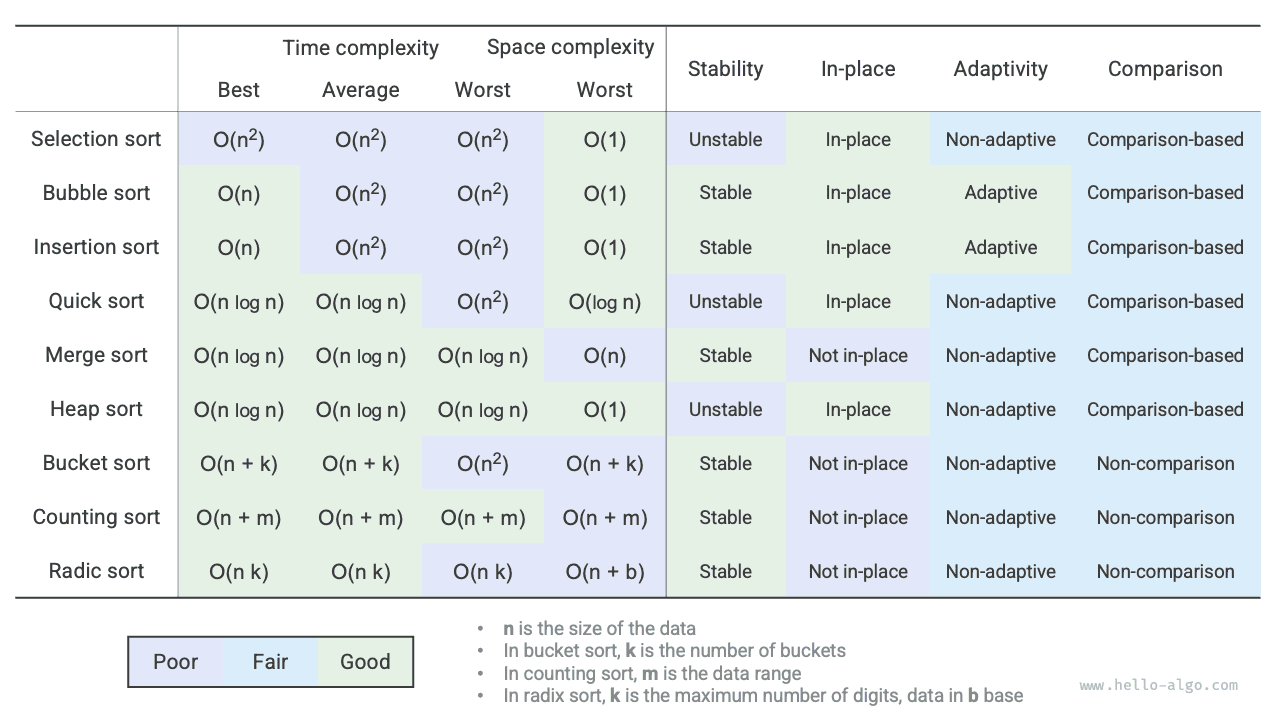
그림 11-19 정렬 알고리즘 비교
2. Q & A
Q: 정렬 알고리즘의 안정성은 어떤 상황에서 필요한가?
실제로 객체의 특정 속성을 기준으로 정렬하는 경우가 있다. 예를 들어 학생에게 이름과 키라는 두 속성이 있고, 여러 기준으로 순차 정렬하고 싶다고 하자. 먼저 이름순으로 정렬하여 (A, 180) (B, 185) (C, 170) (D, 170)을 얻은 뒤 키순으로 정렬한다. 정렬 알고리즘이 불안정하면 (D, 170) (C, 170) (A, 180) (B, 185)가 나올 수 있다.
학생 D와 C의 위치가 바뀌어 이름순 정렬이 깨졌음을 알 수 있으며, 이는 원하는 결과가 아니다.
Q: 센티널 분할에서 '오른쪽에서 왼쪽으로 찾기'와 '왼쪽에서 오른쪽으로 찾기'의 순서를 바꿔도 되는가?
안 된다. 맨 왼쪽 원소를 피벗으로 선택하면 반드시 '오른쪽에서 왼쪽으로 찾기'를 먼저 수행하고, 그다음 '왼쪽에서 오른쪽으로 찾기'를 수행해야 한다. 직관과 다르게 느껴질 수 있으니 이유를 분석해 보자.
분할 함수 partition()의 마지막 단계는 nums[left]와 nums[i]를 교환하는 것이다. 교환 후에는 피벗 왼쪽의 모든 원소에 대해 '원소 <= 피벗'이 성립해야 하므로, 마지막 교환 전에 반드시 nums[left] >= nums[i]가 성립해야 한다. 먼저 '왼쪽에서 오른쪽으로 찾기'를 수행했는데 피벗보다 큰 원소를 찾지 못한다면, i == j일 때 반복문을 빠져나오며 이때 nums[j] == nums[i] > nums[left]일 수 있다. 즉, 마지막 교환이 피벗보다 큰 원소를 맨 왼쪽으로 옮겨 분할을 실패하게 할 수 있다.
예를 들어 배열이 [0, 0, 0, 0, 1]일 때 '왼쪽에서 오른쪽으로 찾기'를 먼저 하면, 분할 결과가 [1, 0, 0, 0, 0]으로 잘못 나온다.
더 생각해 보면 nums[right]를 피벗으로 선택했을 때는 반대로 '왼쪽에서 오른쪽으로 찾기'를 먼저 해야 한다.
Q: 퀵 정렬의 재귀 깊이를 최적화할 때 짧은 배열을 선택하면 왜 깊이가 \(\log n\)을 넘지 않는가?
재귀 깊이는 현재 아직 반환되지 않은 재귀 메서드의 수다. 매 분할에서 원래 배열을 두 부분 배열로 나눈다. 재귀 깊이를 최적화하면 아래로 재귀하는 부분 배열의 길이는 최대 원래 길이의 절반이다. 최악의 경우 매번 정확히 절반이라고 해도 최종 재귀 깊이는 \(\log n\)이다.
원래 퀵 정렬에서는 더 긴 배열에 계속 재귀할 수 있다. 최악의 경우 길이가 \(n\), \(n - 1\), \(\dots\), \(2\), \(1\)로 줄어 재귀 깊이가 \(n\)이 된다. 재귀 깊이 최적화는 이 상황을 방지한다.
Q: 배열의 모든 원소가 같으면 퀵 정렬의 시간 복잡도는 \(O(n^2)\)인가? 이런 퇴화는 어떻게 처리하는가?
그렇다. 이 경우 배열을 피벗보다 작은 부분, 같은 부분, 큰 부분의 세 부분으로 나누고 작은 부분과 큰 부분에만 재귀하는 방법을 고려할 수 있다. 이렇게 하면 모든 원소가 같은 입력 배열은 분할 한 번으로 정렬된다.
Q: 버킷 정렬의 최악 시간 복잡도는 왜 \(O(n^2)\)인가?
최악의 경우 모든 원소가 같은 버킷에 들어간다. 이 원소들을 \(O(n^2)\) 알고리즘으로 정렬한다면 시간 복잡도는 \(O(n^2)\)이다.