11.1 정렬 알고리즘
정렬 알고리즘(sorting algorithm)은 데이터 집합을 특정 순서로 나열하는 데 사용한다. 정렬된 데이터는 대체로 더 효율적으로 탐색, 분석, 처리할 수 있으므로 정렬 알고리즘은 널리 활용된다.
아래 그림(11-1)과 같이 정렬할 데이터의 타입은 정수, 부동 소수점 수, 문자, 문자열 등 다양하다. 정렬 기준도 수의 크기, 문자의 ASCII 코드 순서, 사용자 정의 규칙 등 필요에 따라 정할 수 있다.
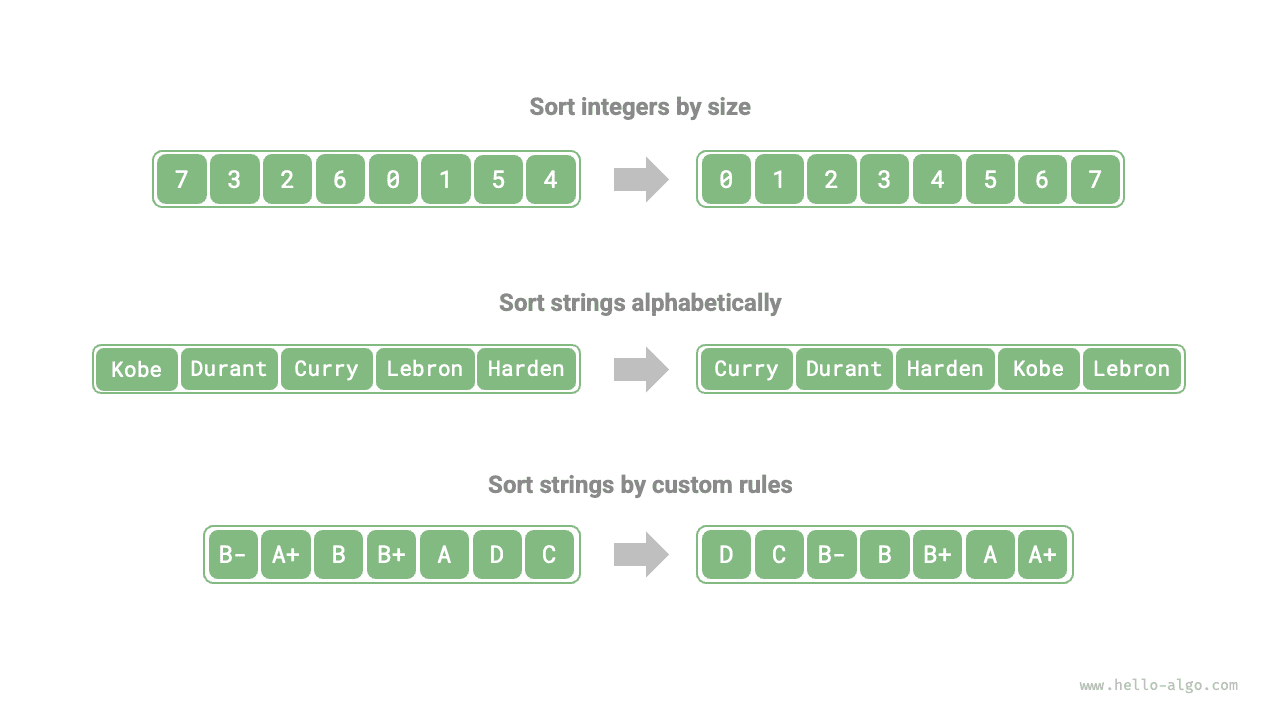
그림 11-1 데이터 타입과 정렬 기준의 예
11.1.1 평가 기준
실행 효율: 정렬 알고리즘은 시간 복잡도가 가능한 한 낮고, 전체 연산 수도 적기를 기대한다(시간 복잡도의 상수항이 작아야 한다). 데이터가 많을 때는 실행 효율이 특히 중요하다.
제자리 여부: 이름 그대로 제자리 정렬은 추가 보조 배열 없이 원래 배열을 직접 조작하여 정렬하므로 메모리를 절약한다. 보통 데이터 이동 연산이 적어 실행 속도도 더 빠르다.
안정성: 안정 정렬은 정렬 후에도 값이 같은 원소들의 배열 내 상대적 순서가 바뀌지 않는다.
안정 정렬은 여러 기준으로 순차 정렬할 때 필요한 조건이다. 학생 정보를 저장한 표의 첫 번째 열이 이름, 두 번째 열이 나이라고 하자. 이때 불안정 정렬을 사용하면 입력 데이터가 기존에 정렬되어 있던 순서가 깨질 수 있다.
# 입력 데이터는 이름순으로 정렬되어 있다
# (name, age)
  ('A', 19)
  ('B', 18)
  ('C', 21)
  ('D', 19)
  ('E', 23)

# 불안정 정렬 알고리즘으로 리스트를 나이순으로 정렬하면,
# 결과에서 ('D', 19)와 ('A', 19)의 상대적 위치가 바뀌어,
# 입력 데이터의 이름순 정렬 상태가 사라질 수 있다
  ('B', 18)
  ('D', 19)
  ('A', 19)
  ('C', 21)
  ('E', 23)
적응성: 적응형 정렬은 입력 데이터에 이미 존재하는 순서 정보를 이용해 계산량을 줄이고 시간 효율을 높일 수 있다. 적응형 정렬 알고리즘의 최선 시간 복잡도는 보통 평균 시간 복잡도보다 낮다.
비교 기반 여부: 비교 기반 정렬은 비교 연산자(\(<\), \(=\), \(>\))로 원소의 상대적 순서를 판단하여 배열 전체를 정렬한다. 최악의 시간 복잡도 하한은 \(\Omega(n \log n)\)이다. 반면 비교를 사용하지 않는 정렬은 비교 연산자를 사용하지 않으며 시간 복잡도가 \(O(n)\)에 이를 수 있지만, 범용성은 상대적으로 낮다.
11.1.2 이상적인 정렬 알고리즘
빠른 실행, 제자리 정렬, 안정성, 적응성, 높은 범용성을 모두 갖추면 이상적이다. 하지만 지금까지 이러한 특성을 모두 갖춘 정렬 알고리즘은 발견되지 않았다. 따라서 데이터의 구체적인 특성과 문제의 요구에 맞추어 정렬 알고리즘을 선택해야 한다.
이제 다양한 정렬 알고리즘을 배우고, 위 평가 기준에 따라 각각의 장단점을 분석해 보자.